 blog.ckdoctor.com
เวลาเก้าโมงเช้า HIS ใช้งานไม่ได้ ห้องตรวจยังมีผู้ป่วยรอ ห้องยาต้องจ่ายยาต่อ และแล็บมีผลตรวจที่ต้องแจ้งด่วน ทีม IT กำลังหาสาเหตุ แต่ระหว่างนั้นใครเป็นคนตัดสินใจว่าจะเปลี่ยนไปใช้วิธีทำงานสำรอง และทุกหน่วยงานจะใช้ข้อมูลชุดไหน?
สถานการณ์สมมตินี้สะท้อนคำถามของ BCP โรงพยาบาล หรือ Business Continuity Plan: เมื่อการทำงานปกติสะดุด โรงพยาบาลจะรักษาบริการที่จำเป็นให้อยู่ในระดับที่ตกลงไว้ได้อย่างไร ตั้งแต่คน กระบวนการ ข้อมูล ไปจนถึงระบบที่ต้องพึ่งพา
บทความนี้นำแนวคิดจาก ISO 22301, WHO, Joint Commission สหรัฐฯ, NHS England และ SAFER Guide มาประยุกต์กับ HIS โดยเน้นการทำงานร่วมกันของทีมรักษา ทีมคุณภาพ ทีม IT และผู้บริหาร ตัวอย่างและ Checklist เป็นข้อเสนอสำหรับนำไปออกแบบตามบริบทของแต่ละโรงพยาบาล
BCP กับ DR: แผนบริการต่อเนื่องเชื่อมกับการกู้ระบบอย่างไร
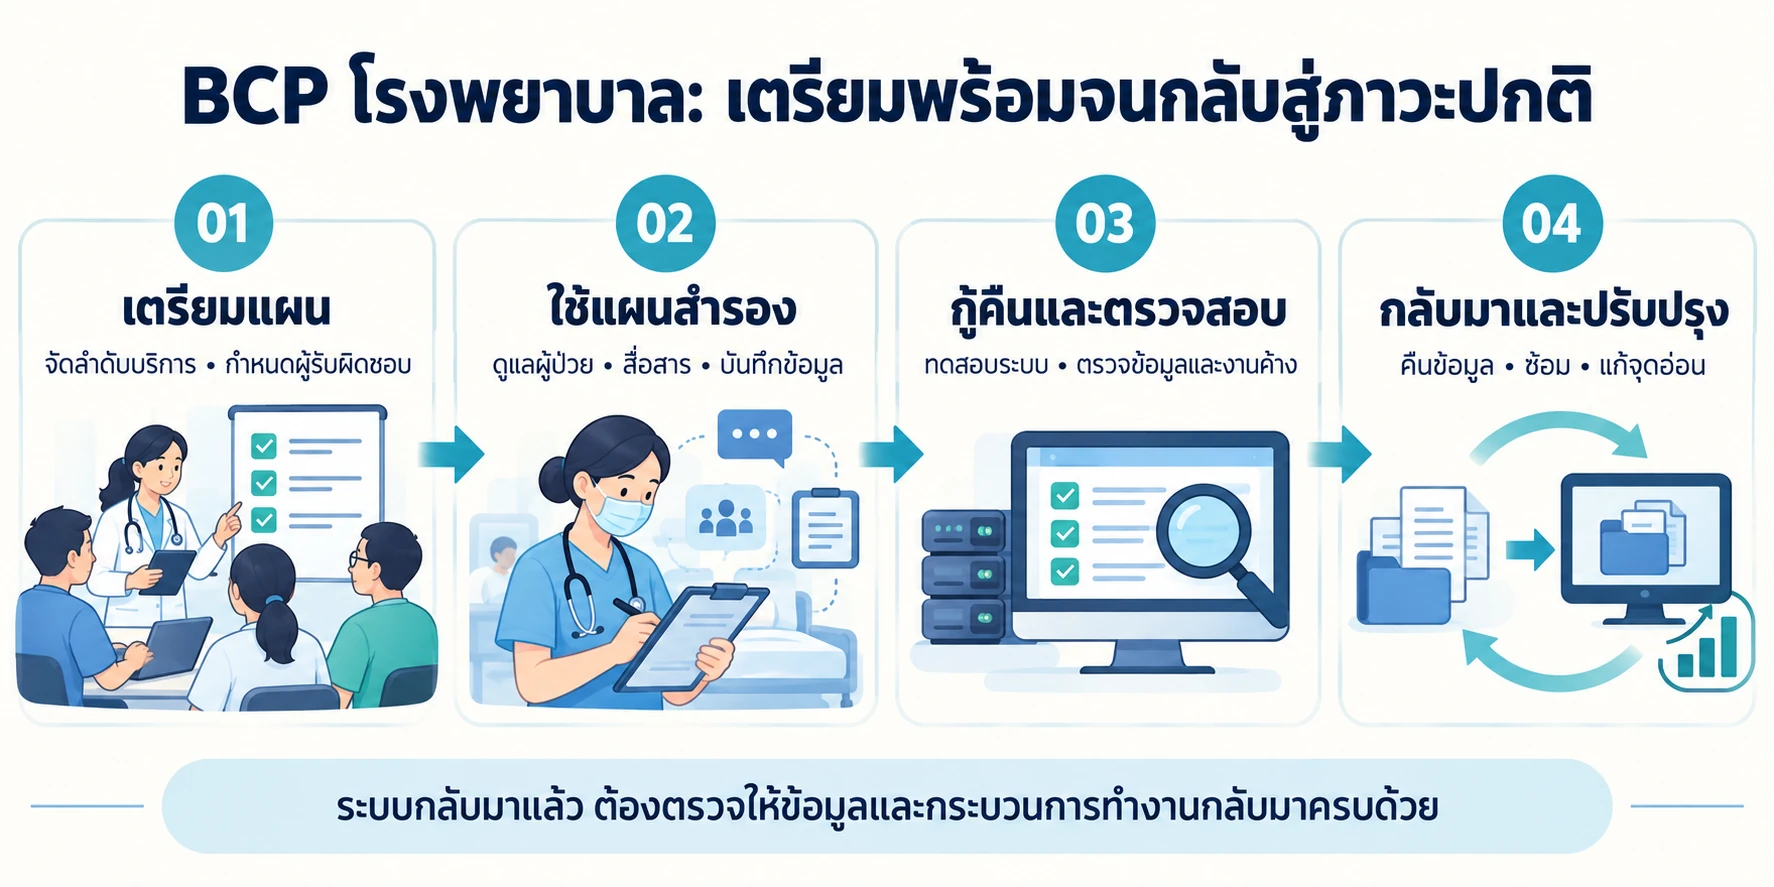
DR — Disaster Recovery มุ่งกู้คืนระบบและข้อมูล ส่วน BCP ครอบคลุมวิธีที่องค์กรจะให้บริการต่อระหว่างเหตุขัดข้อง รวมถึงช่วงที่กำลังฟื้นกลับสู่การทำงานปกติ การกู้ฐานข้อมูลสำเร็จจึงเป็นหมุดหมายหนึ่งของแผน ยังต้องตรวจว่าผู้ใช้และหน่วยงานต่าง ๆ กลับมาทำงานต่อกันได้จริง
ตัวอย่างเช่น ทีม IT เปิด HIS กลับมาได้แล้ว แต่ใบสั่งยาที่เขียนระหว่างระบบล่มยังไม่ได้ตรวจเข้าระบบ ผลตรวจบางรายการยังไม่มีผู้รับทราบ และผู้ป่วยลงทะเบียนใหม่ด้วยเลขชั่วคราว งานฟื้นฟูจึงต้องมีคนรับผิดชอบต่อจนข้อมูลและกระบวนการครบ
พื้นฐานเรื่องระบบสำรองอ่านต่อได้ใน Resilience, High Availability และ DR-Site ส่วนบทความนี้ขยายไปที่แผนการดำเนินงานของโรงพยาบาลทั้งก่อน ระหว่าง และหลัง HIS หยุดให้บริการ
แนวทางสากลให้ความสำคัญกับอะไร
แหล่งอ้างอิงเหล่านี้มีขอบเขตต่างกัน ISO เป็นมาตรฐานระบบบริหาร, Joint Commission ที่อ้างในบทความเป็นกรอบสำหรับโรงพยาบาลในสหรัฐฯ ส่วน WHO, NHS และ SAFER เป็นคู่มือหรือแนวทางนำไปปฏิบัติ การนำแนวคิดมาใช้ต้องพิจารณาข้อกำหนดที่เกี่ยวข้องกับโรงพยาบาลของตนเองด้วย
- ISO 22301: มองความต่อเนื่องเป็นระบบบริหารที่ต้องวางแผน ดำเนินงาน ติดตาม ทบทวน และปรับปรุงอย่างต่อเนื่อง แผนจึงต้องมีเจ้าของและมีหลักฐานว่าใช้ได้ อ่านภาพรวมมาตรฐาน
- WHO: มีคู่มือวางแผนความต่อเนื่องของบริการสำหรับสถานพยาบาลในภาวะฉุกเฉินด้านสาธารณสุข พร้อมขั้นตอนและแม่แบบช่วยจัดทำแผน อ่านคู่มือ WHO
- Joint Commission สหรัฐฯ: ให้ความสำคัญกับการเตรียมพร้อมต่อภัยหลายประเภท การกำกับของผู้นำ การสื่อสาร บุคลากร การดูแลผู้ป่วย ทรัพยากร การฟื้นฟู และการฝึกซ้อมประเมินผล อ่าน Emergency Readiness
- NHS England: ใช้การวิเคราะห์ผลกระทบเพื่อจัดลำดับกิจกรรม กำหนดเวลาฟื้นบริการ และระบุทรัพยากรที่จำเป็น โดยเชื่อมคน สถานที่ เทคโนโลยี ข้อมูล และคู่ค้าเข้าด้วยกัน อ่านเอกสารอบรม BCM
- SAFER Guide: เจาะการเตรียมรับ EHR ใช้งานไม่ได้ เช่น แบบฟอร์มสำรอง การระบุตัวผู้ป่วย การฝึกเจ้าหน้าที่ ช่องทางสื่อสาร และกระบวนการหยุด–เริ่มการแลกเปลี่ยนข้อมูลระหว่างระบบ อ่าน Contingency Planning
เมื่อนำมาประยุกต์กับ HIS คำถามที่ควรถามร่วมกันคือ บริการสำคัญอะไรต้องเดินต่อ ใครตัดสินใจ ใช้ทรัพยากรใด และจะพิสูจน์ความพร้อมอย่างไร
เริ่มจาก BIA: งานไหนหยุดแล้วกระทบผู้ป่วยและบริการอย่างไร
BIA — Business Impact Analysis คือการวิเคราะห์ผลกระทบจากการหยุดชะงักตามระยะเวลา แนวทาง NHS ใช้ผลนี้ช่วยกำหนดความเร่งด่วนและทรัพยากรสำหรับบริการสำคัญ แทนการจัดลำดับจากชื่อระบบเพียงอย่างเดียว NHS: BIA และการกำหนดเป้าหมายฟื้นบริการ
ตัวอย่างการเริ่มประชุมร่วมกัน: ให้ห้องฉุกเฉิน หอผู้ป่วย ห้องยา แล็บ เวชระเบียน และการเงิน อธิบายว่าเมื่อ HIS หยุด งานใดยังทำได้ งานใดต้องเปลี่ยนวิธี และจุดใดต้องส่งต่อให้ผู้มีอำนาจตัดสินใจทางคลินิก แล้วไล่ต่อว่างานนั้นต้องพึ่งข้อมูล บุคลากร อุปกรณ์ เครือข่าย ไฟฟ้า หรือผู้ให้บริการภายนอกใดบ้าง
- RTO — Recovery Time Objective: เป้าหมายเวลาที่ต้องนำบริการหรือกิจกรรมกลับมา ไม่ควรวัดเพียงเวลาที่เครื่องเซิร์ฟเวอร์เปิดติด
- RPO — Recovery Point Objective: จุดข้อมูลย้อนหลังที่ต้องกู้กลับมาได้ หรือช่วงข้อมูลที่องค์กรยอมรับการสูญเสียได้เมื่อเกิดเหตุ
- MTPD — Maximum Tolerable Period of Disruption: ระยะหยุดชะงักก่อนที่ผลกระทบจะเกินระดับที่ยอมรับได้ NHS ใช้คำย่อ MTPoD สำหรับแนวคิดนี้
อ่านนิยาม RPO เพิ่มเติมจาก NIST: Recovery Point Objective ซึ่งอธิบายจุดเวลาก่อนเกิดเหตุที่ต้องกู้ข้อมูลกลับมาได้
โรงพยาบาลต้องกำหนดค่าเหล่านี้ร่วมกันตามบริการและความเสี่ยง พร้อมวางช่วงเผื่อสำหรับตรวจระบบและสะสางงานค้าง ไม่มีตัวเลขเดียวที่เหมาะกับทุกหน่วยงาน และการระบุเป้าหมายในเอกสารต้องตามด้วยการทดสอบว่าสถาปัตยกรรม คน และวิธีทำงานรองรับได้
ใครประกาศใช้แผน และจะสื่อสารกันอย่างไร
แผนที่ใช้ได้ต้องตอบได้ตั้งแต่เริ่มเหตุว่า ใครรับแจ้ง ใครประเมินผลกระทบ ใครประกาศเปลี่ยนวิธีทำงาน และใครมีอำนาจอนุมัติกลับสู่ระบบปกติ แนวทาง Joint Commission วางความรับผิดชอบนี้ไว้ในภาพรวมการจัดการเหตุฉุกเฉินที่ผู้นำต้องกำกับร่วมกับหน่วยงานต่าง ๆ กรอบ Emergency Readiness
ตัวอย่างรายละเอียดที่ควรเขียนลงในแผนของโรงพยาบาล:
- เกณฑ์เริ่มใช้แผน: พิจารณาบริการที่ได้รับผลกระทบ ความเสี่ยง และแนวโน้มการฟื้นตัว รวมถึงกรณีระบบช้าจนทำงานสำคัญไม่ได้
- คนตัดสินใจและผู้แทน: ระบุบทบาท ผู้รับช่วง และวิธีติดต่อทั้งในและนอกเวลาราชการ
- ข้อความประกาศสถานะ: บอกขอบเขตปัญหา วิธีทำงานชั่วคราว ช่องทางขอความช่วยเหลือ และรอบแจ้งข้อมูลครั้งถัดไป
- ช่องทางสำรอง: ต้องเข้าถึงรายชื่อและวิธีสื่อสารได้แม้บริการเครือข่ายหรือระบบยืนยันตัวตนที่ใช้อยู่มีปัญหา
SAFER แนะนำให้กลยุทธ์การสื่อสารช่วงหยุดระบบและช่วงกู้คืนเป็นอิสระจากโครงสร้างคอมพิวเตอร์ที่รองรับ EHR ดังนั้นการเก็บเบอร์ฉุกเฉินไว้เฉพาะใน HIS หรือใช้อีเมลที่พึ่งระบบชุดเดียวกัน อาจไม่เพียงพอ SAFER: แนวทางการสื่อสารช่วง Downtime
ระหว่าง HIS ล่ม: ออกแบบวิธีทำงานสำรองให้เชื่อมถึงกัน
แบบฟอร์มสำรองและวิธีระบุตัวผู้ป่วยเป็นส่วนที่ SAFER ให้ความสำคัญ แต่การนำไปใช้จริงต้องให้ทีมวิชาชีพและหน่วยงานที่เกี่ยวข้องร่วมออกแบบ ทดสอบ และอนุมัติขั้นตอนของโรงพยาบาล SAFER: การเตรียมรับ EHR หยุดให้บริการ
ตัวอย่างคำถามสำหรับทดสอบเส้นทางผู้ป่วยหนึ่งรายตั้งแต่ต้นจนจบ:
- ลงทะเบียนและระบุตัวผู้ป่วย: ใช้ตัวระบุใดเมื่อค้นประวัติไม่ได้ ใครออกเลขชั่วคราว และจะเชื่อมกลับกับเวชระเบียนเดิมอย่างไร
- สั่งการรักษาและจ่ายยา: แบบฟอร์มบันทึกอะไร ใครส่งต่อ ใครยืนยันรับ และค้นข้อมูลสำคัญที่จำเป็นต่อการทำงานได้จากแหล่งที่เตรียมไว้อย่างไร
- ส่งตรวจและรายงานผล: คำสั่ง สิ่งส่งตรวจ และผลตรวจผูกกับผู้ป่วยและผู้รับผิดชอบอย่างไร รวมถึงวิธีแจ้งผลเร่งด่วนตามนโยบายของโรงพยาบาล
- รับไว้รักษา ย้าย และจำหน่าย: ทีมต่าง ๆ อ้างอิงสถานะและตำแหน่งผู้ป่วยจากที่ใด และตรวจความตรงกันอย่างไร
- การเงินและเคลม: เก็บหลักฐานบริการและรายการค่าใช้จ่ายอย่างไรให้ตามกลับได้ ระหว่างที่ยังส่งรายการผ่านระบบปกติไม่ได้
ในเชิงออกแบบ แต่ละรายการควรมีผู้จัดทำ เวลา จุดส่งต่อ และสถานะรับงานที่ตรวจสอบได้ พร้อมวิธีเก็บเอกสารและคุมผู้เข้าถึงข้อมูลช่วงฉุกเฉิน การกลับไปใช้กระดาษต้องมีคน อุปกรณ์ และการฝึกใช้งานรองรับด้วย
ระบบกลับมาแล้ว: ตรวจให้ข้อมูลและงานค้างกลับมาครบ
ช่วงคืนบริการควรมีเกณฑ์รับรองความพร้อมร่วมกัน เช่น ทดสอบงานสำคัญ ตรวจจุดข้อมูลที่กู้ได้ ตรวจสิทธิ์การเข้าถึง และตรวจการเชื่อมต่อที่ต้องใช้ โดยแยกสถานะ “ระบบพร้อมทดสอบ” ออกจาก “พร้อมให้หน่วยงานกลับมาใช้งาน”
SAFER ระบุให้มีวิธีหยุดและเริ่มการแลกเปลี่ยนข้อมูลระหว่างระบบอย่างเป็นลำดับ หลังเหตุหยุดให้บริการ SAFER: Restarting System Interfaces เมื่อนำมาออกแบบร่วมกับ HIS ควรทดสอบกรณีข้อมูลส่งไม่ครบ ส่งซ้ำ หรือปลายทางรับไปแล้วแต่ยังไม่มีคำตอบกลับ
ตัวอย่างกระบวนการคืนข้อมูลและสะสางงานที่โรงพยาบาลอาจกำหนด:
- ตกลงเวลาเปลี่ยนจากวิธีสำรองกลับสู่ HIS และแจ้งทุกหน่วยงานให้เข้าใจตรงกัน
- รวบรวมเอกสารและข้อมูลช่วงหยุดระบบ แยกผู้ป่วย รายการบริการ และงานที่ยังรอดำเนินการ
- ตรวจเลขชั่วคราว คำสั่งยา ผลตรวจ และรายการค่าใช้จ่ายกับผู้รับผิดชอบ ก่อนบันทึกหรือส่งต่อเข้าระบบ
- ตรวจรายการซ้ำ รายการขาด และรายการที่สถานะระหว่างต้นทางกับปลายทางยังไม่ตรงกัน โดยไม่ส่งซ้ำทั้งหมดโดยอัตโนมัติ
- เก็บทั้งเวลาที่เกิดบริการจริงและเวลาที่นำข้อมูลเข้าระบบย้อนหลัง พร้อมผู้บันทึก ผู้ตรวจ และประวัติการแก้ไข
- ปิดเหตุเมื่อหน่วยงานรับรองความพร้อมตามเกณฑ์ และระบุเจ้าของกับกำหนดติดตามสำหรับงานค้างที่ยังเหลือ
จุดนี้ทำให้การทดสอบกู้คืนมีความหมายต่อหน้างานมากขึ้น: ต้องตรวจทั้งระบบ ข้อมูล และการส่งต่องาน อ่านแนวคิดการเก็บหลักฐานต่อได้ใน Audit Log ของ HIS
ซ้อมแผนให้เห็นจุดอ่อน แล้ววัดจากงานที่กลับมาได้จริง
การฝึกซ้อมและประเมินผลเป็นส่วนหนึ่งของกรอบ Joint Commission ขณะที่แนวทาง NHS เชื่อมการทดสอบเข้ากับการทบทวนและปรับปรุงแผน Joint Commission · NHS BCM Workshop
ตัวอย่างการวางรอบซ้อมตามความพร้อมและความเสี่ยงของโรงพยาบาล:
- Tabletop: จำลองเหตุบนโต๊ะประชุม ให้ผู้เกี่ยวข้องตัดสินใจตามบทบาท แล้วตรวจว่าคำตอบหรือทรัพยากรใดในแผนยังขาด
- Technical Recovery Test: กู้ระบบและข้อมูลในสภาพแวดล้อมแยก ตรวจความครบถ้วนและจับเวลาตามขอบเขตที่กำหนด
- Workflow Drill: ให้ผู้ใช้ทดลองเส้นทางงานด้วยข้อมูลทดสอบ ตั้งแต่รับผู้ป่วย สั่งยา ส่งตรวจ จนคืนข้อมูลเข้า HIS
ออกแบบการซ้อมโดยผู้รับผิดชอบประเมินผลกระทบและเตรียมวิธีหยุดหรือย้อนกลับ ไม่จำเป็นต้องเริ่มจากตัดระบบใช้งานจริง การเพิ่มความสมจริงควรทำตามแผนที่ควบคุมได้
ตัวชี้วัดที่เสนอให้เก็บ ได้แก่ เวลาเริ่มใช้วิธีสำรอง เวลากลับมาใช้บริการสำคัญ จุดข้อมูลที่กู้กลับมาได้ จำนวนรายการขาดหรือซ้ำ และเวลาสะสางงานค้าง แต่ละค่าควรมีนิยาม ขอบเขต และผู้ยืนยันผล พร้อมบันทึกช่องว่าง ผู้แก้ไข และการทดสอบซ้ำ
เริ่มทบทวน BCP โรงพยาบาลด้วยคำถาม 8 ข้อนี้
- ระบุบริการสำคัญและผลกระทบเมื่อหยุดตามระยะเวลาแล้วหรือยัง?
- ตกลง RTO, RPO และระดับบริการขั้นต่ำร่วมกับเจ้าของงานแล้วหรือยัง?
- มีคนประกาศใช้แผน คนตัดสินใจแทน และเกณฑ์กลับสู่ภาวะปกติชัดเจนหรือไม่?
- ช่องทางแจ้งเหตุ รายชื่อติดต่อ และแผนยังเปิดใช้ได้เมื่อระบบหลักเข้าไม่ได้หรือไม่?
- ทีมหน้างานเคยทดลองแบบฟอร์มและวิธีทำงานสำรองด้วยกันแล้วหรือยัง?
- กู้ได้ครบทั้งข้อมูล การตั้งค่าที่จำเป็น และระบบที่บริการต้องพึ่งพาหรือไม่?
- มีเจ้าของงานคืนข้อมูล ตรวจรายการซ้ำ และสะสางงานค้างหลังฟื้นระบบหรือไม่?
- การซ้อมครั้งล่าสุดพบอะไร ใครรับผิดชอบแก้ และได้ทดสอบผลหลังแก้แล้วหรือยัง?
จุดเริ่มต้นที่ทำได้คือเลือกบริการสำคัญหนึ่งเส้นทาง แล้วให้ทีมรักษา เวชระเบียน ห้องยา แล็บ IT และผู้บริหารลองเดินตามสถานการณ์เดียวกัน ตั้งแต่รับแจ้งเหตุจนคืนข้อมูลครบ ผลที่ได้จะช่วยบอกว่าแผนส่วนไหนพร้อม และส่วนไหนยังต้องลงทุนหรือปรับวิธีทำงาน
BCP ที่พร้อมใช้งานต้องทำให้คนรู้หน้าที่ บริการสำคัญเดินต่อ และเมื่อ HIS กลับมา ข้อมูลกับกระบวนการทำงานต้องกลับมาครบด้วย
แหล่งอ้างอิงและแนวทางอ่านต่อ
- ISO 22301:2019 — Business Continuity Management Systems: ภาพรวมมาตรฐานระบบบริหาร
- WHO — Health service continuity planning for public health emergencies: คู่มือสำหรับสถานพยาบาล (2021)
- Joint Commission สหรัฐฯ — Emergency Readiness: การเตรียมพร้อมและฟื้นบริการของโรงพยาบาล
- NHS England — Business Continuity Management Workshop: BIA, RTO, MTPoD และการซ้อมแผน (2023)
- SAFER Guide — Contingency Planning: แนวทางความปลอดภัยเมื่อ EHR ใช้งานไม่ได้ ในชุดคู่มือ 2025
นิยามเพิ่มเติม: NIST — Recovery Point Objective (RPO)
ตรวจทานแหล่งข้อมูลวันที่ 23 ตุลาคม 2569 บทความนี้สังเคราะห์หลักการเพื่อประยุกต์ใช้กับ HIS ตัวอย่างกระบวนการเป็นข้อเสนอของผู้เขียน ไม่ใช่ข้อกำหนดรายข้อหรือการรับรองความสอดคล้องกับมาตรฐาน
